
Yandex outage fiel mit der Verlagerung bösartiger bot-Aktivität zusammen
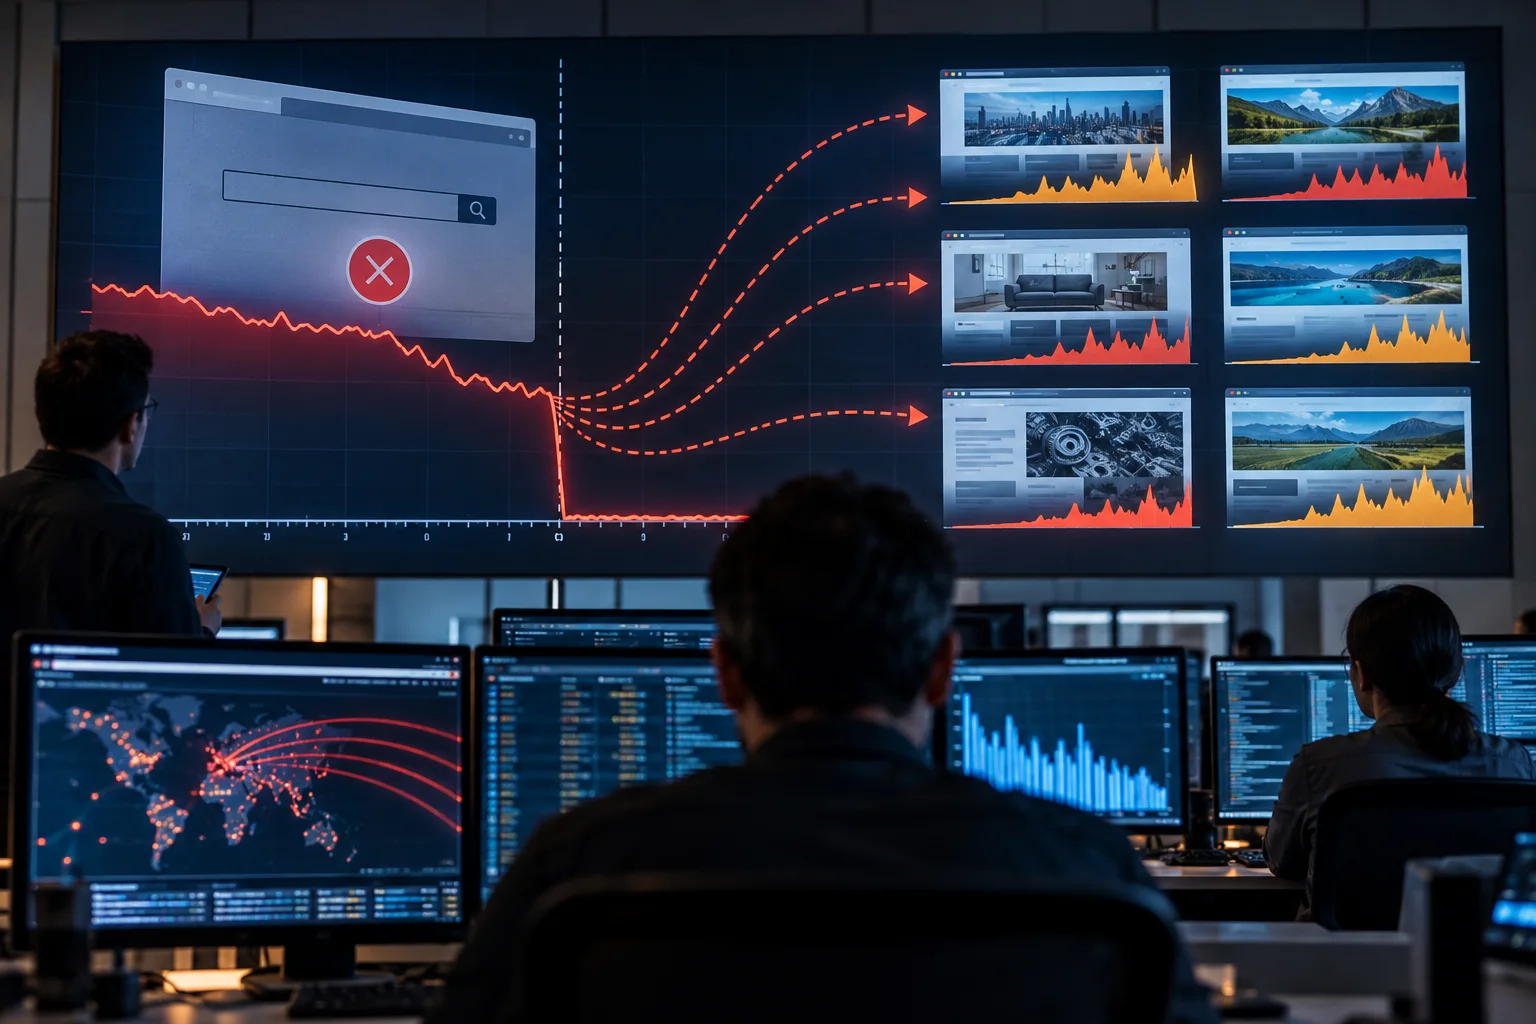
Die Yandex outage fiel damit zusammen, dass bösartige bot-Systeme ihre Aktivität verlagerten, statt einfach zu verschwinden, wie aus einer am 14. Oktober 2026 von Cloudflare veröffentlichten Analyse hervorgeht. Ein bot ist Software, die automatisierte Anfragen stellt oder Online-Aktionen ausführt, ohne dass eine Person jede einzelne davon steuert. Cloudflare bezeichnete die bot-Systeme in diesem Fall als bösartig. Das bedeutet, dass die Automatisierung mit schädlichen Aktivitäten verbunden war und nicht mit legitimen Funktionen wie search indexing oder service monitoring.
Die zentrale Erkenntnis verändert, wie eine outage aus Sicherheitsperspektive interpretiert werden sollte. Eine outage ist ein Zeitraum, in dem ein Dienst nicht verfügbar oder erheblich beeinträchtigt ist. Sie kann den normalen Traffic zum betroffenen Dienst verringern, doch die Analyse von Cloudflare zeigt, dass feindliche Automatisierung aktiv bleiben und sich an andere Orte verlagern kann. Die mit diesem Vorfall verbundenen bot-Systeme verschwanden nicht einfach zusammen mit Yandex vom Netz. Die Beschreibung von Cloudflare zeigt für sich genommen nicht, wohin jede einzelne bot-Instanz wechselte, welche Aktionen sie jeweils ausführte oder wodurch die outage verursacht wurde. Diese Punkte sollten daher nicht als erwiesen betrachtet werden.
Für Websitebetreiber und IT-Teams lautet die praktische Erkenntnis, dass die Verfügbarkeit eines Dienstes und bösartige Aktivitäten getrennt voneinander überwacht werden müssen. Ein Dashboard, das einen Dienst als offline anzeigt, kann einen Rückgang des Traffic erklären. Es kann jedoch nicht zeigen, ob automatisierter Missbrauch aufgehört oder sich zu einem anderen Ziel verlagert hat. Teams sollten während einer externen outage weiterhin andere Websites, Anwendungen, Login-Systeme und öffentliche Interfaces beobachten, statt anzunehmen, dass eine geringere Aktivität an einer Stelle auch eine allgemeine Verringerung des Risikos bedeutet.
Hier wird observability wichtig, also das Sammeln von Informationen, die Betreibern dabei helfen zu verstehen, was ein System tut. Verfügbarkeitsprüfungen beantworten, ob ein Dienst reagiert, während traffic metrics die Anzahl und die Muster von Anfragen zeigen. Logs sind mit Zeitstempeln versehene Aufzeichnungen von Systemereignissen und können zeigen, was angefordert wurde und ob wiederholte Versuche Login-Seiten, Formulare oder andere öffentlich zugängliche Bereiche einer Website erreichten. Warnmeldungen können anschließend das Personal benachrichtigen, wenn die Aktivität von einer erwarteten baseline abweicht, also von dem normalen Muster, das zum Vergleich herangezogen wird.
Die Yandex outage veranschaulicht außerdem, warum es nicht ausreicht, nur eine einzige Gesamtkennzahl für den Traffic zu überwachen. Wenn automatisierte Anfragen ein Ziel verlassen und an anderer Stelle auftreten, kann ein allgemeiner Rückgang konzentrierte Aktivitäten gegen ein anderes System verbergen. Betreiber sollten den Traffic verschiedener Dienste vergleichen und die Art der gestellten Anfragen untersuchen, statt lediglich darauf zu achten, ob das Anfragevolumen steigt oder fällt. Diese Analyse muss sich weiterhin auf Belege stützen: Eine Veränderung während einer outage ist ein Hinweis, der untersucht werden sollte, aber kein automatischer Beweis dafür, dass die outage die Veränderung verursacht hat oder dass jede automatisierte Anfrage feindlich ist.
Incident-Verfahren sollten daher mehr umfassen als die Wiederherstellung des nicht verfügbaren Dienstes. Teams können relevante Logs sichern, prüfen, ob Warnmeldungen ausgelöst wurden, Authentifizierungsversuche untersuchen und Aktivitäten gegen Formulare oder andere öffentlich erreichbare Funktionen überprüfen. Sie sollten außerdem dokumentieren, wann Veränderungen begannen und endeten, damit Traffic-Muster mit dem zeitlichen Verlauf der outage verglichen werden können. Dadurch erhalten die zuständigen Personen eine klarere Grundlage, um gewöhnliche Störungen von bot-Aktivität zu unterscheiden, die sich auf ein anderes Ziel verlagert hat.
Auch Websitebetreiber ohne eigenes Sicherheitsteam können dasselbe Prinzip anwenden. Während einer größeren outage bei einem Drittanbieter können sie die von ihrem Hosting- oder Websiteverwaltungsdienst bereitgestellten Traffic- und Sicherheitsansichten prüfen, nach plötzlichen Zunahmen wiederholter Anfragen suchen und ihren Anbieter bitten, unerklärliche Veränderungen zu untersuchen. Administratorkonten sollten two-factor authentication verwenden, die zusätzlich zu einem Passwort eine zweite Bestätigung verlangt, da automatisierte Versuche häufig auf öffentlich erreichbare Anmeldeseiten abzielen.
Für Organisationen, die externe Unterstützung bei der Prüfung dieses umfassenderen Betriebsrisikos benötigen, bietet AEU-I sicherheitsorientierte IT-, Infrastruktur- und Beratungsleistungen an. Die übergeordnete Schlussfolgerung aus der Analyse von Cloudflare ist eindeutig: Wenn eine Onlineplattform nicht mehr verfügbar ist, sollten die Verantwortlichen den Rest ihrer Umgebung weiterhin überwachen, da sich bösartige bot-Aktivität verlagern kann, statt aufzuhören.