
Yandex outage përkoi me zhvendosjen e aktivitetit të bots keqdashës
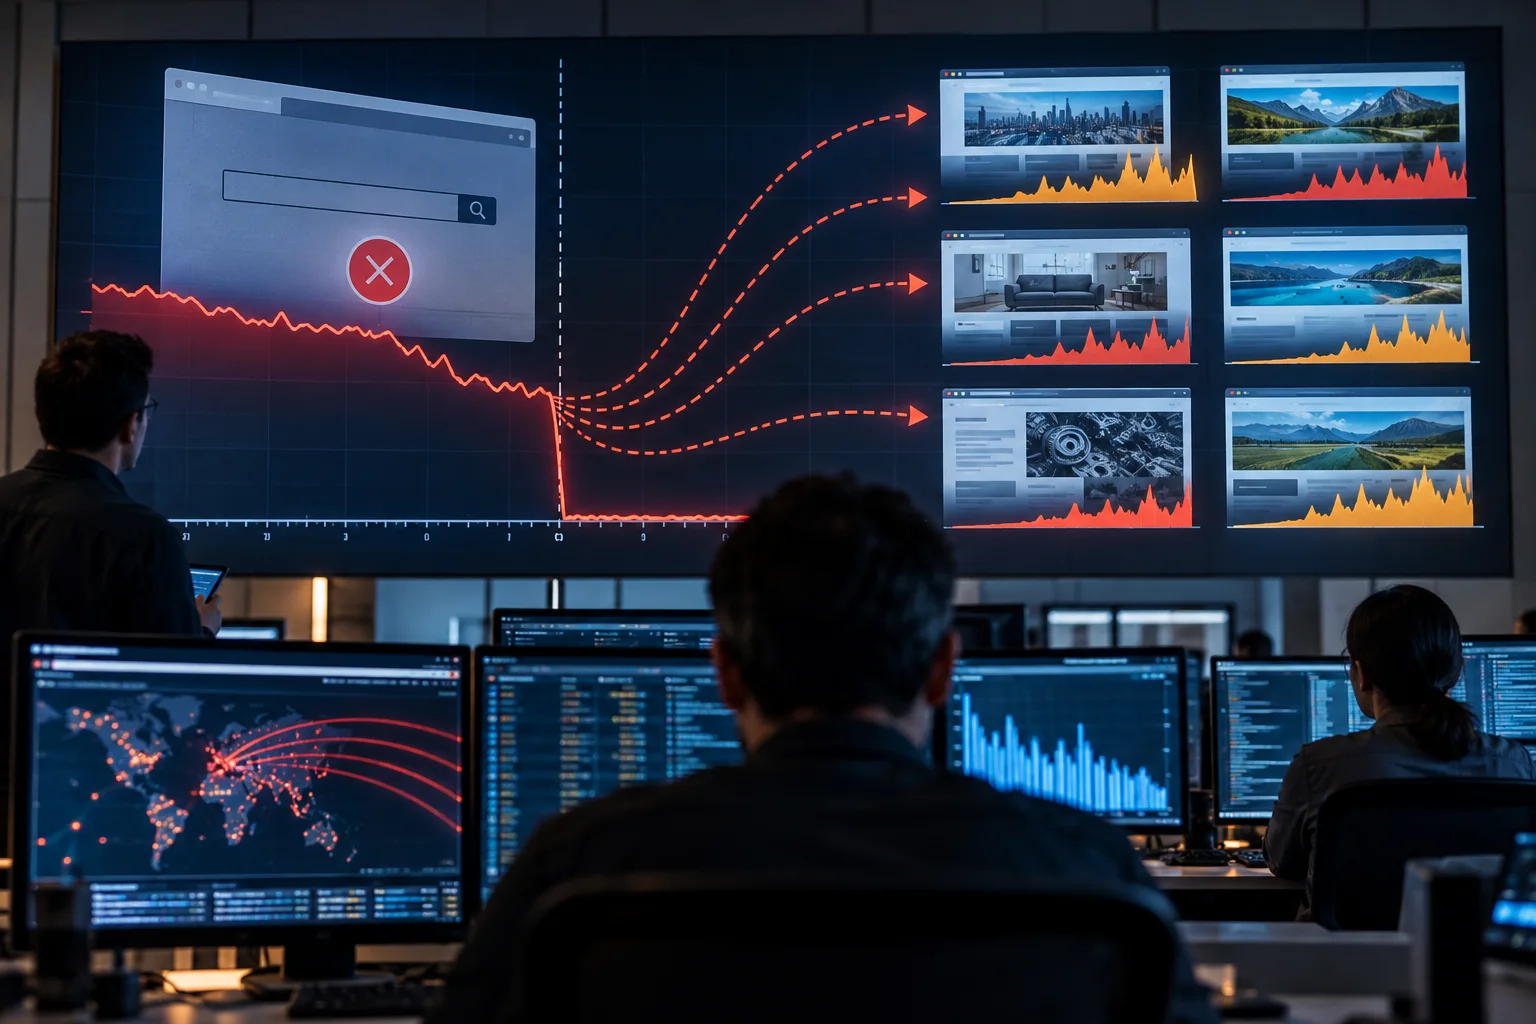
Yandex outage përkoi me zhvendosjen e aktivitetit të bots keqdashës në vend që ata thjesht të zhdukeshin, sipas analizës së publikuar nga Cloudflare më 14 tetor 2026. Një bot është software që bën automated requests ose kryen veprime online pa pasur nevojë që një person të drejtojë secilin prej tyre. Cloudflare i përshkroi bots në këtë rast si keqdashës, që do të thotë se automatizimi lidhej me veprimtari të dëmshme dhe jo me funksione legjitime, si search indexing ose monitorimi i shërbimeve.
Gjetja kryesore ndryshon mënyrën se si duhet interpretuar një outage nga këndvështrimi i sigurisë. Një outage është një periudhë gjatë së cilës një shërbim nuk është i disponueshëm ose pëson ndërprerje serioze. Ai mund ta zvogëlojë trafikun normal drejt shërbimit të prekur, por analiza e Cloudflare tregon se automatizimi armiqësor mund të mbetet aktiv dhe të zhvendoset diku tjetër. Bots e lidhur me këtë incident nuk u çaktivizuan thjesht së bashku me Yandex. Përshkrimi i Cloudflare nuk përcakton në vetvete se ku shkoi çdo bot, çfarë veprimesh kreu secili ose çfarë e shkaktoi outage, ndaj këto pika nuk duhet të trajtohen si fakte të vërtetuara.
Për pronarët e faqeve të internetit dhe ekipet e IT, mësimi praktik është se disponueshmëria e shërbimit dhe aktiviteti keqdashës janë dy gjëra të veçanta që duhen monitoruar. Një dashboard që tregon se një shërbim është offline mund të shpjegojë rënien e trafikut, por nuk mund të tregojë nëse abuzimi i automatizuar është ndalur apo është zhvendosur drejt një destinacioni tjetër. Gjatë një outage të jashtëm, ekipet duhet të vazhdojnë të vëzhgojnë faqet e tjera të internetit, aplikacionet, sistemet e login dhe ndërfaqet publike, në vend që të supozojnë se aktiviteti i reduktuar në një vend nënkupton një ulje më të gjerë të rrezikut.
Këtu bëhet e rëndësishme observability, pra mbledhja e informacionit që i ndihmon operatorët të kuptojnë se çfarë po bën një sistem. Kontrollet e disponueshmërisë tregojnë nëse një shërbim përgjigjet, ndërsa traffic metrics tregojnë sasitë dhe modelet e kërkesave. Logs, që janë të dhëna me shënim kohor për ngjarjet e sistemit, mund të tregojnë se çfarë u kërkua dhe nëse përpjekjet e përsëritura arritën te faqet e login, formularët ose pjesë të tjera të ekspozuara të një faqeje interneti. Alerts më pas mund ta njoftojnë stafin kur aktiviteti largohet nga baseline i pritshëm, domethënë nga modeli normal që përdoret për krahasim.
Yandex outage tregon gjithashtu pse nuk mjafton monitorimi i vetëm një shifre për trafikun e përgjithshëm. Nëse automated requests largohen nga një destinacion dhe shfaqen diku tjetër, një rënie e përgjithshme mund të fshehë aktivitet të përqendruar kundër një sistemi tjetër. Operatorët duhet ta krahasojnë trafikun midis shërbimeve dhe të shqyrtojnë llojin e kërkesave që po bëhen, jo vetëm nëse vëllimi i kërkesave po rritet apo po bie. Kjo analizë duhet të mbështetet te provat: një ndryshim gjatë një outage është një sinjal për të hetuar, jo provë automatike se outage e shkaktoi ndryshimin ose se çdo kërkesë e automatizuar është armiqësore.
Prandaj, procedurat për incidentet duhet të përfshijnë më shumë sesa rikthimin e shërbimit të padisponueshëm. Ekipet mund të ruajnë Logs përkatëse, të kontrollojnë nëse u aktivizuan alerts, të shqyrtojnë përpjekjet e authentication dhe të rishikojnë aktivitetin kundrejt formularëve ose funksioneve të tjera të aksesueshme publikisht. Gjithashtu, duhet të dokumentojnë se kur filluan dhe përfunduan ndryshimet, në mënyrë që modelet e trafikut të krahasohen me kronologjinë e outage. Kjo u jep personave që reagojnë ndaj incidentit një bazë më të qartë për të dalluar ndërprerjen e zakonshme nga aktiviteti i bot që është zhvendosur drejt një objektivi tjetër.
Pronarët e faqeve të internetit që nuk kanë një ekip të dedikuar sigurie mund të zbatojnë përsëri të njëjtin parim. Gjatë një outage të madh të një pale të tretë, ata mund të kontrollojnë pamjet e trafikut dhe sigurisë që ofrohen nga shërbimi i tyre i hosting ose i administrimit të faqes së internetit, të kërkojnë rritje të papritura të kërkesave të përsëritura dhe t'i kërkojnë ofruesit të tyre të hetojë ndryshimet e pashpjegueshme. Llogaritë administrative duhet të përdorin two-factor authentication, i cili kërkon një konfirmim të dytë përveç fjalëkalimit, sepse përpjekjet e automatizuara zakonisht përqendrohen te faqet e ekspozuara të login.
Për organizatat që kanë nevojë për ndihmë të jashtme për shqyrtimin e këtij rreziku më të gjerë operacional, AEU-I ofron IT, infrastrukturë dhe konsulencë me sigurinë si përparësi. Përfundimi më i gjerë nga analiza e Cloudflare është i drejtpërdrejtë: kur një platformë online bëhet e padisponueshme, mbrojtësit duhet të vazhdojnë monitorimin e pjesës tjetër të mjedisit të tyre, sepse aktiviteti i bots keqdashës mund të zhvendoset në vend që të ndalet.