
L’outage di Yandex ha coinciso con lo spostamento dei bot malevoli
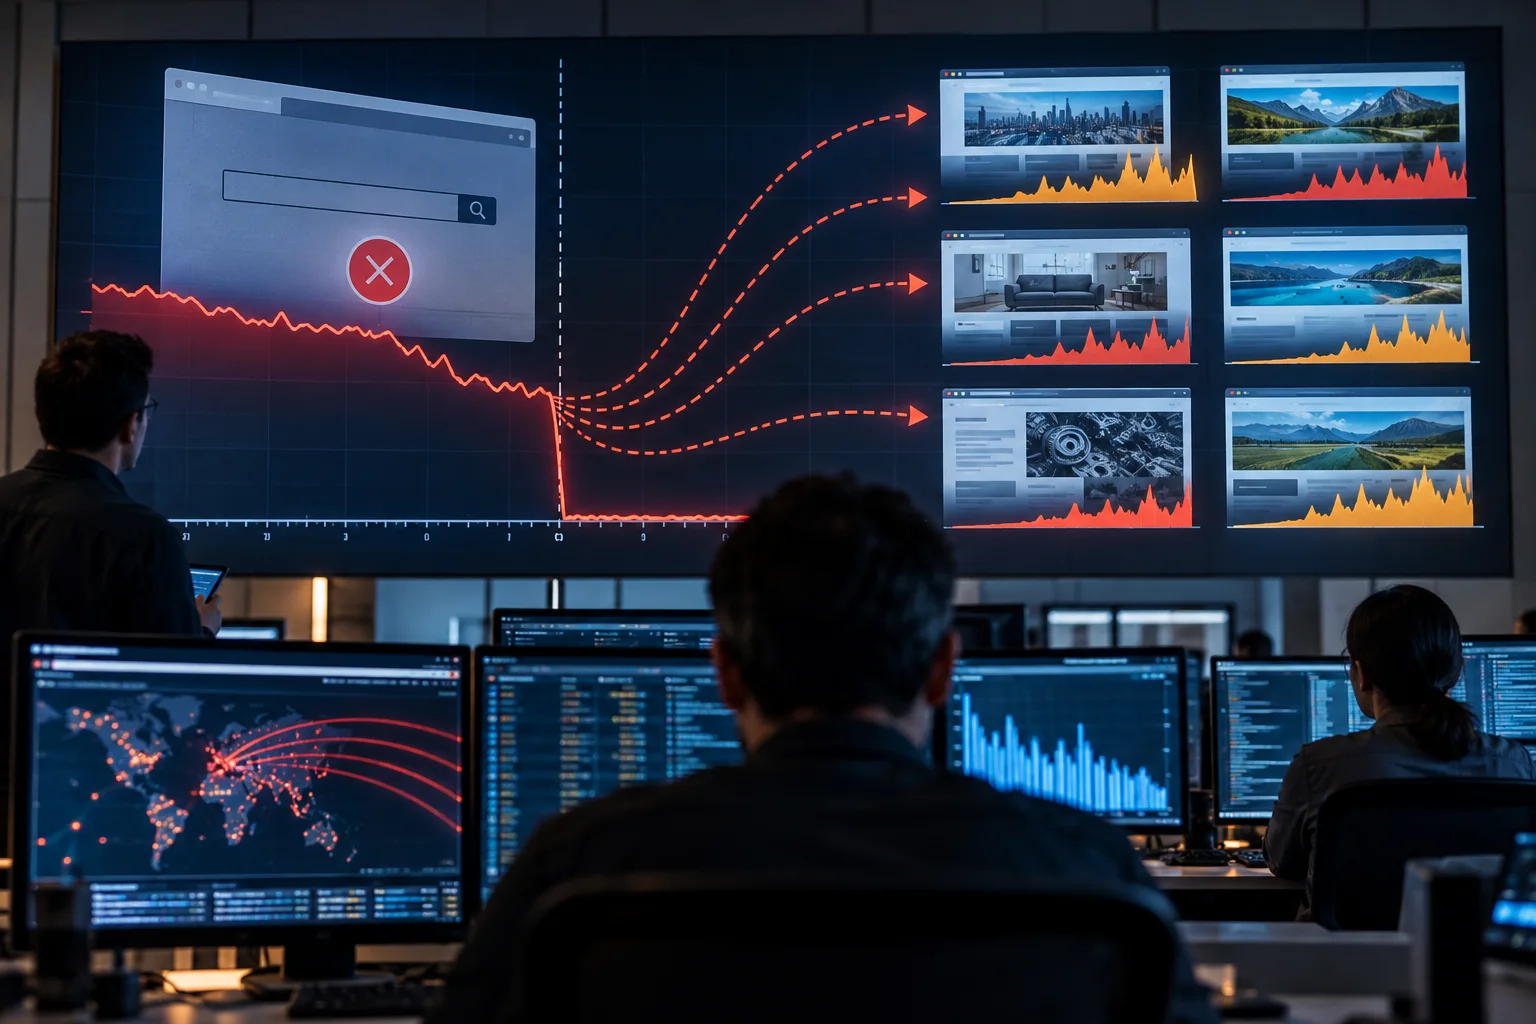
L’outage di Yandex ha coinciso con lo spostamento dell’attività dei bot malevoli anziché con la loro semplice scomparsa, secondo un’analisi pubblicata da Cloudflare il 14 ottobre 2026. Un bot è un software che invia richieste automatizzate o esegue azioni online senza che una persona debba gestirle una per una. Cloudflare ha descritto i bot coinvolti in questo caso come malevoli, indicando che l’automazione era associata ad attività dannose anziché a funzioni legittime come l’indicizzazione per i motori di ricerca o il monitoraggio dei servizi.
La conclusione principale cambia il modo in cui un’outage dovrebbe essere interpretata dal punto di vista della sicurezza. Un’outage è un periodo durante il quale un servizio non è disponibile o subisce gravi interruzioni. Può ridurre il traffico normale diretto al servizio interessato, ma l’analisi di Cloudflare indica che l’automazione ostile può rimanere attiva e spostarsi altrove. I bot associati a questo incidente non sono semplicemente diventati inattivi insieme a Yandex. La descrizione di Cloudflare non permette, da sola, di stabilire dove sia andato ciascun bot, quali azioni abbia eseguito o che cosa abbia causato l’outage; questi elementi non devono quindi essere considerati accertati.
Per i proprietari di siti web e i team IT, la lezione pratica è che la disponibilità dei servizi e le attività malevole sono due aspetti distinti da monitorare. Una dashboard che mostra un servizio offline può spiegare una diminuzione del traffico, ma non può indicare se gli abusi automatizzati siano cessati o si siano spostati verso un’altra destinazione. Durante un’outage esterna, i team dovrebbero continuare a controllare gli altri siti web, le applicazioni, i sistemi di accesso e le interfacce pubbliche, anziché presumere che la riduzione dell’attività in un luogo corrisponda a una più ampia diminuzione del rischio.
È qui che diventa importante l’observability, ossia la raccolta di informazioni che aiuta gli operatori a capire che cosa sta facendo un sistema. I controlli di disponibilità indicano se un servizio risponde, mentre le traffic metrics mostrano le quantità e gli schemi delle richieste. I Logs, ovvero registrazioni con data e ora degli eventi di sistema, possono mostrare che cosa è stato richiesto e se tentativi ripetuti hanno raggiunto pagine di accesso, moduli o altre parti esposte di un sito web. Gli avvisi possono quindi informare il personale quando l’attività si discosta dalla baseline prevista, cioè dal normale schema usato come termine di confronto.
L’outage di Yandex dimostra inoltre perché non sia sufficiente monitorare un unico dato relativo al traffico complessivo. Se le richieste automatizzate abbandonano una destinazione e compaiono altrove, una diminuzione generale può nascondere un’attività concentrata contro un altro sistema. Gli operatori dovrebbero confrontare il traffico tra i diversi servizi ed esaminare il tipo di richieste effettuate, non soltanto verificare se il loro volume aumenti o diminuisca. L’analisi deve rimanere basata sulle prove: un cambiamento durante un’outage è un segnale da approfondire, non una prova automatica che l’outage abbia causato tale cambiamento o che ogni richiesta automatizzata sia ostile.
Le procedure di gestione degli incidenti dovrebbero quindi includere più del semplice ripristino del servizio non disponibile. I team possono conservare i Logs pertinenti, verificare se siano scattati degli avvisi, esaminare i tentativi di autenticazione e controllare le attività rivolte ai moduli o ad altre funzioni accessibili pubblicamente. Dovrebbero inoltre documentare quando sono iniziati e terminati i cambiamenti, in modo da poter confrontare gli schemi di traffico con la cronologia dell’outage. Ciò fornisce agli addetti alla risposta una base più chiara per distinguere una normale interruzione dall’attività dei bot che si è spostata verso un obiettivo diverso.
Anche i proprietari di siti web privi di un team di sicurezza dedicato possono applicare lo stesso principio. Durante una grave outage di un servizio di terze parti, possono controllare le sezioni relative al traffico e alla sicurezza messe a disposizione dal proprio servizio di hosting o di gestione del sito web, cercare aumenti improvvisi delle richieste ripetute e chiedere al proprio fornitore di esaminare i cambiamenti inspiegabili. Gli account amministrativi dovrebbero utilizzare la two-factor authentication, che richiede una seconda conferma oltre alla password, perché i tentativi automatizzati prendono spesso di mira le pagine di accesso esposte.
Per le organizzazioni che necessitano di assistenza esterna nella valutazione di questo più ampio rischio operativo, AEU-I offre servizi IT, infrastrutturali e di consulenza orientati in primo luogo alla sicurezza. La conclusione generale dell’analisi di Cloudflare è semplice: quando una piattaforma online diventa indisponibile, i responsabili della difesa dovrebbero continuare a monitorare il resto del proprio ambiente, perché l’attività dei bot malevoli potrebbe spostarsi anziché cessare.